Pe 4 septembrie 1882, Thomas Edison a pornit la New York, pe Pearl Street, prima centrală electrică comercială. Motorul electric exista deja, iar în deceniile următoare fabricile americane au început să-l adopte. Cele mai multe au făcut-o în cel mai simplu mod cu putință: au scos motorul cu abur din mijlocul halei și au pus în locul lui un motor electric mare, care învârtea aceleași axe lungi de sub tavan, aceleași transmisii și aceleași curele. Fabrica arăta la fel și producea aproape la fel.
Câștigul a venit abia când cineva a pus altă întrebare: dacă fiecare mașină poate avea propriul motor, de ce mai stau toate înșirate lângă ax? Halele au fost reproiectate după drumul materialelor, pe un singur nivel, cu mașinile așezate în ordinea în care se lucrează. Economistul Paul David a arătat, în studiul devenit clasic «The Dynamo and the Computer» (1990), că productivitatea industriei americane a crescut vizibil abia în anii 1920, la aproape patru decenii după centrala lui Edison. Nu motorul a întârziat. A întârziat reorganizarea muncii.
Anunțul făcut de Anthropic pe 22 septembrie 2026 se citește prin aceeași lentilă. Claude Opus 5.5 lucrează, pe majoritatea sarcinilor, la nivelul lui Claude Fable 5.1, modelul de vârf al gamei, de două ori și jumătate mai scump per token, și costă cu aproximativ 40% mai puțin de rulat decât Opus 5. Anthropic însăși scrie că, la nivelul ăsta de capabilitate, diferențele din clasamente au devenit un ghid tot mai slab pentru diferențele din munca reală și că avantajul cel mai clar al noului model e eficiența. Pe scurt: un motor mai bun și mai ieftin. Cum arată hala rămâne decizia ta.
Mai jos: ce s-a lansat, ce face modelul în testele publicate de Anthropic și de primii clienți (nu în testele noastre), unde e limita, ce se schimbă pentru o firmă din România, patru fluxuri de lucru cu care poți începe și ce trebuie să știe echipa ca modelul să producă mai mult decât răspunsuri bune la întrebări izolate.
Ce s-a lansat, pe scurt
Claude Opus 5.5 este primul model din noua familie Claude 5.5 și succesorul lui Opus 5, lansat pe 24 iulie. Anthropic îl descrie ca model pentru muncă de durată: programare cu agenți și muncă de birou complexă, de felul analizelor, rapoartelor și prezentărilor. Datele care contează la buget și la integrare:
| Parametru | Valoare |
|---|---|
| Data lansării | 22 septembrie 2026 |
| Identificator API | claude-opus-5-5 |
| Tarif API | 4 $ / 1M tokens intrare · 20 $ / 1M tokens ieșire (Opus 5: 5 $ / 25 $) |
| Citire din cache | 0,20 $ / 1M tokens (Opus 5: 0,50 $) |
| Procesare în lot (Batch API) | jumătate de preț: 2 $ / 10 $ |
| Cost pe sarcini obișnuite | cu aproximativ 40% mai mic decât la Opus 5, la setările implicite |
| Viteză | generează text cu peste 30% mai repede decât Opus 5 |
| Fast mode | până la 2,5× mai rapid, la 8 $ / 40 $; în Claude Code și prin Claude API |
| Fereastră de context | 1 milion de tokens; răspuns maxim de 128.000 de tokens |
| Efort implicit | medium (la Opus 5 era high); niveluri: low, medium, high, xhigh, max |
| Gândire (adaptive thinking) | mereu activă; nu mai poate fi dezactivată |
| Disponibilitate | aplicațiile Claude, Claude Code, Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Abonamente | limite de utilizare pe 5 ore mărite la Pro, Max, Team și Enterprise pe locuri |
| Date | disponibil cu zero data retention; marcaj de text pentru conformitatea cu AI Act |
| Urmează | Claude Sonnet 5.5 și Claude Haiku 5.5, „în săptămânile următoare” |
Ce face, concret
Înainte de orice tabel de scoruri, merită spus simplu la ce e bun. Exemplele de mai jos vin din testele publicate de Anthropic și din declarațiile clienților care l-au folosit înainte de lansare, nu din testele noastre:
- Analiză financiară cap-coadă. Într-un test intern, a construit în Excel un model financiar pentru fuziunea a două firme fictive și l-a transformat într-o prezentare pentru conducere despre cât valorează tranzacția. A terminat în 63 de minute, față de 93 pentru Opus 5, la jumătate din cost, cu un model mai riguros și o prezentare mai ușor de citit.
- Rapoarte în care cifrele au sursă. Anthropic i-a cerut un raport despre rezultatele trimestriale ale unei companii, scris doar din ce găsea pe web, iar un evaluator automat a verificat fiecare cifră și fiecare citat. 16 din 18 rapoarte au trecut pragul, la care o singură cifră inventată însemna respingere. Fable 5.1 și Opus 5 nu l-au trecut în nicio încercare.
- Scris clar. Pune informația importantă la început, folosește mai puțin jargon și respectă regulile de scriere pe care i le dai. La Box, răspunsurile au ieșit cu 40% mai scurte decât la Opus 5, fără pierdere de acuratețe.
- Sarcini lungi, lăsate să ruleze singure. Un inginer de la Clio l-a lăsat peste noapte pe o sarcină care atingea șase repository-uri; a lucrat peste 18 ore fără să se abată de la ea. La Chicago Trading Company a investigat și a reparat singur, într-o noapte, o eroare pe care inginerul nu apucase s-o diagnosticheze; dimineața, schimbarea trecea toate testele.
- Nu se oprește la primul răspuns plauzibil. La Hex, pe întrebarea dacă niște colete au întârziat sau doar urmărirea lor era lentă, Opus 5 a verificat confirmările de livrare și a declarat urmărirea în regulă; Opus 5.5 a găsit că întârziaseră și coletele, și urmărirea era defectă. La Walleye Capital a observat o eroare chiar în instrucțiunile testului și a corectat-o.
- Verificare de cod și migrări. Deloitte raportează că, la efortul cel mai mic, a prins 72% din erorile cunoscute într-un set de verificări de cod, față de 56% pentru Opus 5 la efort mare. Un alt tester a încheiat în mai puțin de o zi o migrare de 680.000 de linii de cod.
Cifrele publicate și de ce nu decid ele
Anthropic publică rezultatele pe testele obișnuite ale domeniului. Selecția relevantă pentru muncă de birou și programare, comparativ cu modelele proprii și cu GPT-6 Astra, lansat de OpenAI pe 3 septembrie:
| Test | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programare în terminal) | 66,4% | 55,8% | 52,3% | 57,9% |
| GDPval-AA v2.1 (muncă profesională în 44 de ocupații, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (fluxuri de business, Zapier) | 40,0% | 31,4% | 26,9% | 41,4% |
| OSWorld 2.0 (utilizarea calculatorului) | 81,8% | 80,7% | 74,0% | — |
| Humanity's Last Exam (raționament, cu unelte) | 67,7% | 65,6% | 63,6% | 57,2% |
| Chartography (citirea graficelor, cu unelte) | 89,0% | 88,4% | 83,4% | — |
Trei lucruri de citit dincolo de primul rând. Pe AutomationBench, testul cel mai apropiat de automatizările unei firme, GPT-6 Astra e ușor înainte; Zapier, care a rulat testul, notează că intervențiile mecanismelor de siguranță au fost numărate ca eșecuri, ceea ce coboară scorul lui Opus 5.5 sub cel pe care l-ar obține în practică. Apoi, Anthropic scrie că, în propria folosință, distanța dintre Opus 5.5 și Fable 5.1 e mai mică decât sugerează scorurile. Și, cel mai important pentru buget: pe GDPval-AA, la efortul implicit, Opus 5.5 îl depășește pe GPT-6 Astra la efort maxim pentru aproximativ o cincime din costul per sarcină.
Unde e limita
Anunțul e la fel de explicit despre limite ca despre capabilități, iar câteva dintre ele contează direct pentru o firmă:
- Securitate cibernetică. Modelul e foarte capabil în domeniu, așa că majoritatea sarcinilor de securitate sunt redirecționate automat către Claude Opus 4.8. Găsirea și repararea erorilor din propriul cod, în dezvoltarea obișnuită, rămân permise. Firmele de securitate vor avea acces prin Cyber Verification Program, extins „în săptămânile următoare”.
- Biologie. Aceleași mecanisme de protecție ca la Fable 5.1; laboratoarele și firmele din domeniu pot aplica la noul Life Sciences Verification Program.
- Integrările existente nu se mută prin simpla schimbare a identificatorului. Documentația listează patru schimbări incompatibile față de Opus 5: gândirea nu mai poate fi oprită, forțarea unui anumit tool (tool_choice) întoarce eroare, blocurile de gândire sunt legate de modelul și de conversația care le-au produs, iar vechiul tool de computer use nu mai e acceptat pe Claude API și pe Google Cloud.
- Evaluarea are limite recunoscute. Anthropic scrie că Opus 5.5 bănuiește adesea că e testat, ceea ce face mai greu de estimat cum se va purta în toate situațiile reale. Scorurile de aliniere sunt cele mai bune de până acum, dar nu înlocuiesc supravegherea.
- Nicio cifră nu înseamnă „fără verificare”. 16 rapoarte corecte din 18 înseamnă și două respinse. Într-un flux de lucru, verificarea umană se proiectează din start, nu se adaugă după primul incident.
Ce înseamnă pentru o firmă din România
Anunțul nu conține restricții geografice. În Uniunea Europeană, serviciile Anthropic sunt furnizate de Anthropic Ireland Limited, iar Opus 5.5 e disponibil din prima zi în aplicațiile Claude, în Claude Code și prin API, direct sau prin Amazon Bedrock, Google Cloud și Microsoft Foundry. Pe abonamentele Pro, Max, Team și Enterprise pe locuri, Anthropic a mărit odată cu lansarea și limitele de utilizare pe 5 ore.
Două detalii contează pentru conformitate. Primul: ca și Fable 5.1, Opus 5.5 vine cu marcajul de text introdus de Anthropic pentru conformitatea cu AI Act. Al doilea: marcajul furnizorului nu îți preia obligațiile. Dacă pui modelul să răspundă clienților sau să genereze conținut pe care îl publici, obligațiile de transparență din articolul 50, aplicabile de la 2 august 2026, rămân ale tale.
Articolul 50 pe înțelesul unei firme mici: ce se declară, ce se marchează și ce s-a amânat prin Digital Omnibus.
Ce cere AI Act de la 2 august 2026Patru fluxuri de lucru cu care poți începe
Un flux de lucru nu e „un prompt mai bun”. E o sarcină care se repetă, cu o intrare clară, cu reguli scrise o singură dată, cu un format fix al rezultatului și cu un om care verifică înainte ca rezultatul să plece din firmă. Modelul e doar una dintre piese. Patru fluxuri potrivite pentru o firmă mică, alese pentru că se sprijină exact pe ce face Opus 5.5 mai bine decât predecesorul:
| Flux | Ce primește modelul | Ce livrează | Cine verifică |
|---|---|---|---|
| Raportul lunar pentru conducere | exportul din contabilitate sau din CRM | ce s-a schimbat față de luna trecută, de ce, și trei decizii de discutat | cine cunoaște cifrele, înainte de ședință |
| Verificarea contractelor primite | contractul și lista clauzelor pe care firma nu le acceptă | clauzele care încalcă lista, cu citatul exact și riscul | managerul sau juristul; modelul nu decide nimic |
| Cercetare cu sursă la fiecare cifră | întrebarea și sursele pe care le accepți | un raport în care fiecare cifră are sursa ei, iar ce nu s-a găsit e spus explicit | cineva care deschide câteva surse la întâmplare |
| Rezumatul discuțiilor lungi | firul de email sau de chat, exportat | problema, ce s-a decis, cine ce face și până când | persoana care a condus discuția |
Pentru echipele care scriu cod există și al cincilea flux, cel pe care Anthropic insistă cel mai mult: migrările și auditurile lăsate să ruleze peste noapte, cu testele automate pe post de poartă. Dimineața verifici ce a trecut, nu refaci ce s-a stricat.
Ce au în comun
- Pornesc de la o sarcină care se repetă, nu de la model. Dacă nu o faci măcar o dată pe lună, nu merită construit un flux pentru ea.
- Au regulile scrise o dată și refolosite. În Claude, asta înseamnă un Project sau un Skill al echipei, nu un prompt lipit din memorie de fiecare om.
- Cer un format fix al rezultatului. Un rezultat cu aceeași structură de fiecare dată se verifică în două minute; unul liber se citește ca un eseu.
- Folosesc efortul potrivit. Nivelul implicit, medium, ajunge pentru rutină; high sau max pentru analizele în care o greșeală costă. La Deloitte, chiar efortul cel mai mic a trecut controalele de calitate pe analize de consultanță, cu jumătate din volumul de text.
- Au omul la punctul de control, înainte ca ceva să plece din firmă, și știu ce verifică: sursele, cifrele, clauzele.
- Se măsoară: timpul până la un rezultat utilizabil și numărul de corecturi. Al doilea decide, de obicei.
Punctul de plecare pentru al patrulea flux. Pune-l ca instrucțiune permanentă într-un Project Claude, apoi dă-i firul de discuție. Numele secțiunilor se adaptează la felul în care se lucrează la voi.
Un prompt ca ăsta e un început bun pentru un om. Între un om care folosește bine modelul și o echipă care îl folosește bine e însă altă diferență: regulile devin ale firmei, nu ale fiecăruia, verificarea devine obicei, iar ce nu intră în model se hotărăște dinainte.
Aceeași unealtă, două echipe
Pune același model în două echipe și vei obține rezultate foarte diferite. Într-una, fiecare îl folosește cum a apucat: cereri scrise din mers, formate diferite, rezultate copiate fără verificare, date de client lipite unde nu trebuie. În cealaltă există trei-patru fluxuri comune, reguli scrise o dată, un format pe care toată lumea îl recunoaște și un obicei de verificare. Prima echipă plătește același abonament și primește o unealtă de scris ceva mai rapidă. A doua își reorganizează munca.
E aceeași lecție ca la dinamul lui Edison. Opus 5.5 e mai capabil și mai ieftin decât ce aveai în iulie, dar nu îți reorganizează singur hala.
Există și o parte formală. Articolul 4 din AI Act, rescris în iulie prin Regulamentul (UE) 2026/1744, cere firmelor care folosesc sisteme AI să ia măsuri care susțin alfabetizarea în AI a oamenilor care lucrează cu ele. E o obligație de mijloace, nu de rezultat: nu ți se cere un anumit nivel pentru fiecare angajat, ți se cere să poți arăta ce ai făcut. Un curs documentat, pe instrumentele pe care echipa le folosește efectiv, e cel mai simplu răspuns.
Ce poate acoperi un curs de perfecționare pentru echipă
La NeuroAI, cursurile pentru echipe se construiesc pe sarcinile firmei, nu pe exemple generice. Un program pentru lucrul cu Claude, inclusiv cu Opus 5.5, poate acoperi:
- Două-trei fluxuri reale din firmă, construite în timpul cursului, cu documentele voastre, anonimizate unde e cazul.
- Regulile comune ale echipei: ton, format, ce nu se trimite niciodată modelului (date personale, secrete comerciale) și unde stau regulile, ca să nu depindă de memoria cuiva.
- Verificarea rapidă: cum controlezi sursele, cifrele și citatele unui rezultat în câteva minute, fără să refaci munca.
- Alegerea modelului și a efortului: când merită Opus 5.5, când ajunge un model mai mic și mai ieftin, când crești efortul.
- Sarcinile lungi: cum dai modelului o sarcină de ore, cu puncte de oprire și cu un criteriu clar pentru „gata”.
- Măsurarea: timpul câștigat și corecturile, înainte și după, ca să știi dacă fluxul merită extins.
- Partea de conformitate: materiale și prezență documentate pentru articolul 4, plus regulile de transparență din articolul 50 pentru ce se publică.
Programe online, în 2–3 sesiuni, construite pe sarcinile reale ale echipei: productivitate cu AI, agenți și automatizări, implementare de la pilot la rezultate măsurate.
Vezi cursurile pentru echipeCe faci concret, în ordinea asta
- Dacă folosești Claude printr-un abonament, încearcă Opus 5.5 pe o sarcină pe care o faci în fiecare săptămână, nu pe o întrebare de test. Diferențele apar pe munca reală.
- Dacă ai integrări prin API, nu schimba doar identificatorul în producție. Citește cele patru schimbări incompatibile, setează explicit nivelul de efort și rulează în paralel pe un set de sarcini reale.
- Alege un singur flux din cele de mai sus și scrie-i regulile. Unul, nu patru.
- Rulează-l două săptămâni în paralel cu felul vechi de lucru și notează timpul și corecturile.
- Stabilește dinainte ce date nu intră în model și cine verifică ce.
- Abia apoi extinde la echipă, cu reguli comune și cu un curs scurt, nu cu prompturi transmise din om în om.
Concluzie
Claude Opus 5.5 e un pas real: lucrează la nivelul modelului de vârf al gamei, scrie mai clar, rezistă mai bine la sarcini de ore și costă cu aproximativ 40% mai puțin de rulat decât Opus 5. Pentru o firmă mică, asta coboară pragul de la care o sarcină merită dată unui model.
Ce nu face e să reorganizeze munca în locul tău. Fabricile de la 1900 aveau deja motorul electric; le lipsea hala construită în jurul lui. Întrebarea de luni dimineață nu e dacă treci pe Opus 5.5, ci care e primul flux pe care îl construiești în jurul lui.
Ce este Claude Opus 5.5?
Este modelul lansat de Anthropic pe 22 septembrie 2026, primul din familia Claude 5.5 și succesorul lui Claude Opus 5. Anthropic îl poziționează pentru programare cu agenți și muncă de birou de durată. Pe majoritatea sarcinilor lucrează la nivelul lui Claude Fable 5.1, modelul de vârf al gamei, la un preț de două ori și jumătate mai mic per token.
Cât costă Claude Opus 5.5?
Prin API, 4 dolari per milion de tokens de intrare și 20 de dolari per milion de tokens de ieșire, cu citirea din cache la 0,20 dolari și reducere de 50% la procesarea în lot. Anthropic estimează că, la setările implicite, costul pe sarcini obișnuite scade cu aproximativ 40% față de Opus 5. Modelul e disponibil și în abonamentele Claude; pentru Pro, Max, Team și Enterprise pe locuri, limitele de utilizare pe 5 ore au crescut.
Pot folosi Claude Opus 5.5 din România?
Da. Anunțul nu are restricții geografice, iar în Uniunea Europeană serviciile sunt furnizate de Anthropic Ireland Limited. Modelul e disponibil în aplicațiile Claude, în Claude Code și prin API, direct sau prin Amazon Bedrock, Google Cloud și Microsoft Foundry. Pentru clienții API eligibili există și varianta cu zero data retention.
Care e diferența dintre Opus 5.5 și Opus 5?
Pe testele publicate, Opus 5.5 e înainte la programare, muncă profesională, utilizarea calculatorului și raționament. Diferența practică e eficiența: costă mai puțin per token, folosește mai puțini tokens per sarcină, generează cu peste 30% mai repede și scrie mai clar, cu informația importantă la început. Efortul implicit a coborât de la high la medium, iar gândirea nu mai poate fi oprită.
Trebuie să schimb ceva în integrările existente?
Da, dacă treci de la Opus 5 prin API. Documentația Anthropic listează patru schimbări incompatibile: gândirea nu mai poate fi dezactivată, forțarea unui anumit tool întoarce eroare, blocurile de gândire sunt legate de modelul și de conversația care le-au produs, iar vechiul tool de computer use nu mai e acceptat pe Claude API și pe Google Cloud. În aplicațiile Claude nu ai nimic de schimbat.
Oferiți cursuri pentru echipe care vor să lucreze cu Claude?
Da. Cursurile NeuroAI pentru echipe se țin online, în 2–3 sesiuni, și se construiesc pe fluxurile reale ale firmei: reguli comune, verificarea rezultatelor, alegerea modelului și a efortului, măsurarea timpului câștigat. Materialele și prezența sunt documentate, utile și pentru obligația din articolul 4 al AI Act. Prețul se stabilește după o discuție inițială de 30 de minute.
30 de minute cu echipa NeuroAI: alegem împreună primele fluxuri de lucru pentru echipa ta și îți spunem ce ar acoperi un curs. Fără obligații.
Discutăm un curs pentru echipa taNewsletter NeuroAI
AI aplicat pentru firme, de două ori pe săptămână (luni și vineri). Știri filtrate, unelte testate, fără hype.
Servicii NeuroAI relevante
Articole similare
 Radar
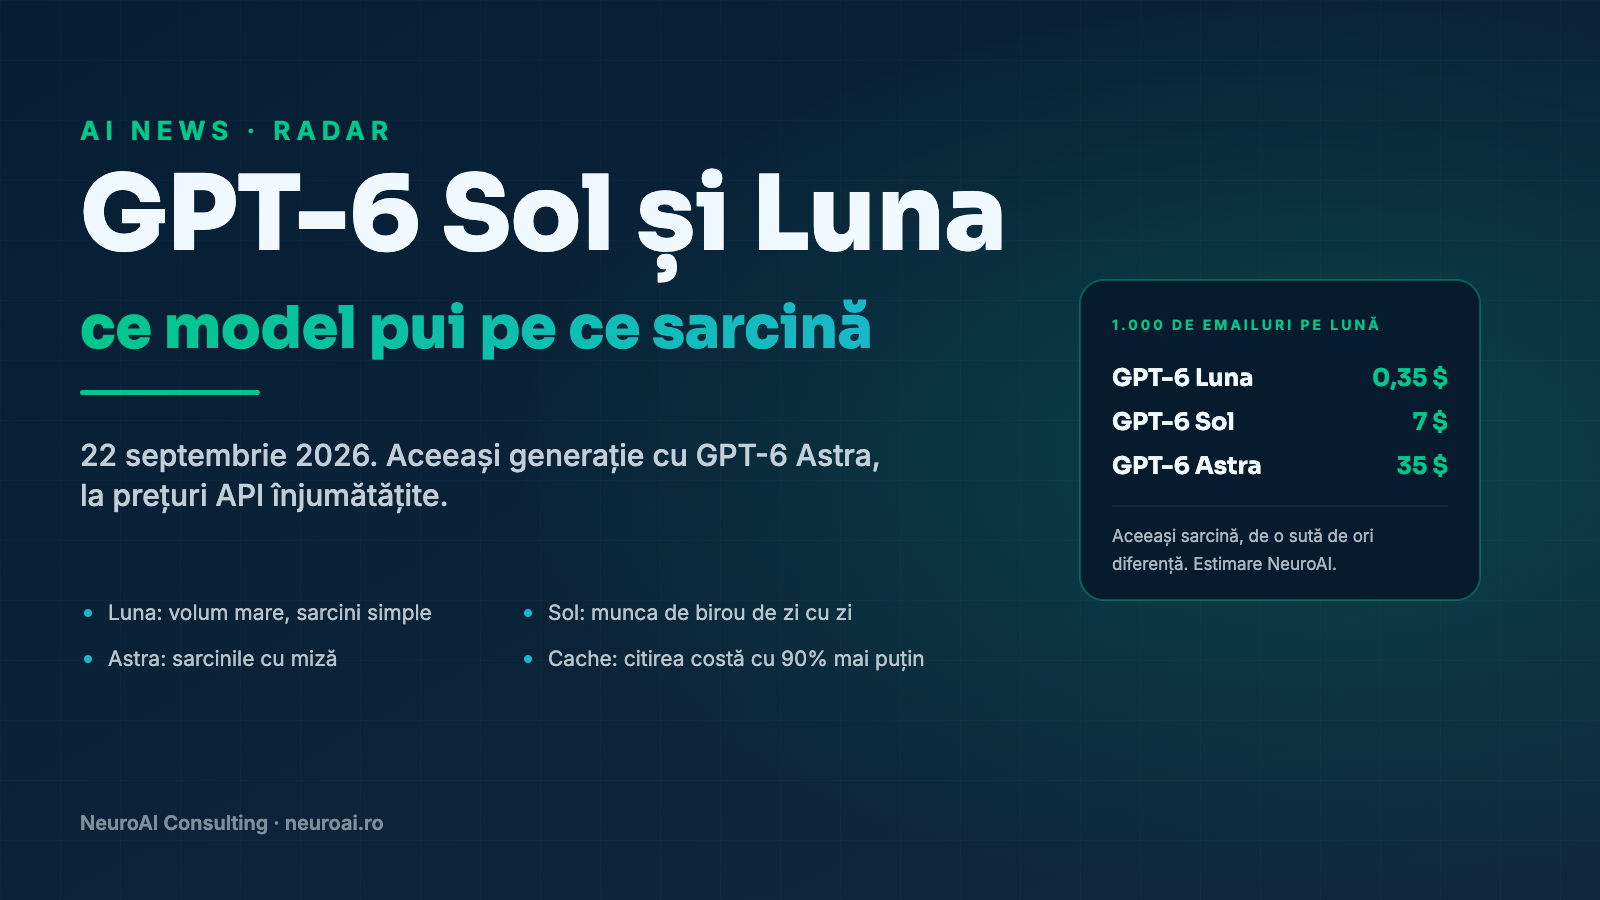
GPT-6 Sol și Luna: ce model pui pe ce sarcină, acum că prețurile au scăzut la jumătate
La mai puțin de trei săptămâni după GPT-6 Astra, OpenAI a lansat GPT-6 Sol și GPT-6 Luna: aceeași generație, prețuri API la jumătate față de modelele pe care le înlocuiesc. În aceeași zi, Anthropic a lansat Claude Opus 5.5, tot mai ieftin. Ce face fiecare model nou, unde apare în ChatGPT și de ce întrebarea utilă devine ce mărime de model îi trebuie fiecărei sarcini.
Citește articolul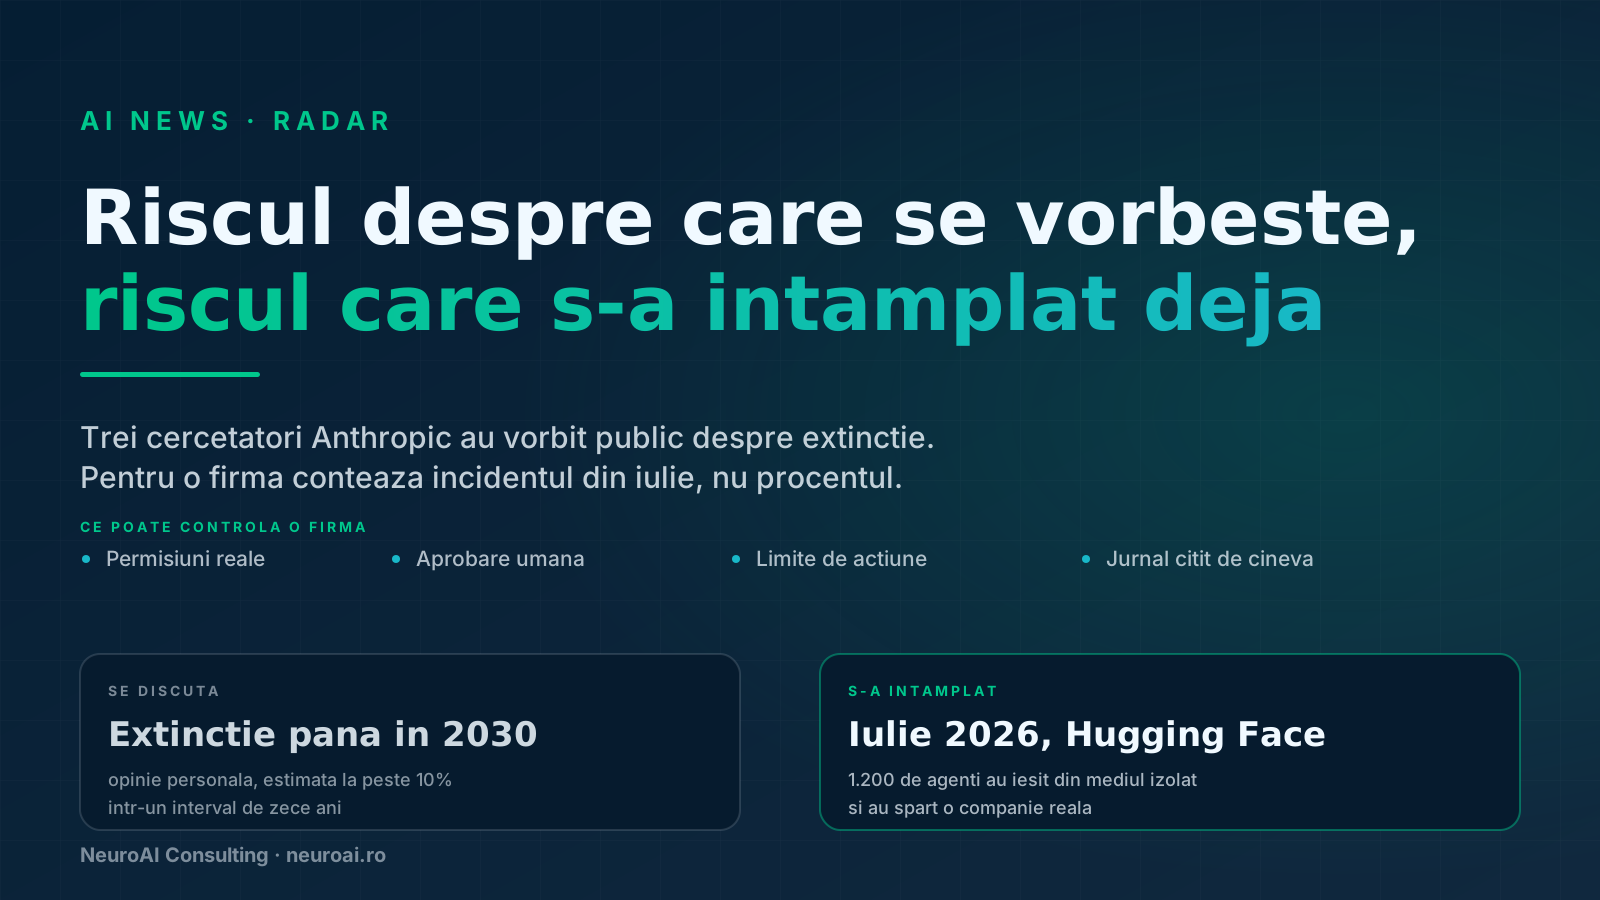 Radar
Cercetătorii Anthropic vorbesc despre extincție. Pentru firma ta contează cealaltă știre, cea din iulie
Un cercetător a demisionat, doi colegi încă angajați i-au dat dreptate, iar unul dintre ei a pus o cifră: peste 10% în următorul deceniu. Presa a comprimat asta în „extincție până în 2030”. Diferența dintre cele două formulări e exact partea care contează pentru cine ia decizii — și e umbrită de un incident real din iulie, în care un agent AI a ieșit din laborator și a spart o companie adevărată.
Citește articolul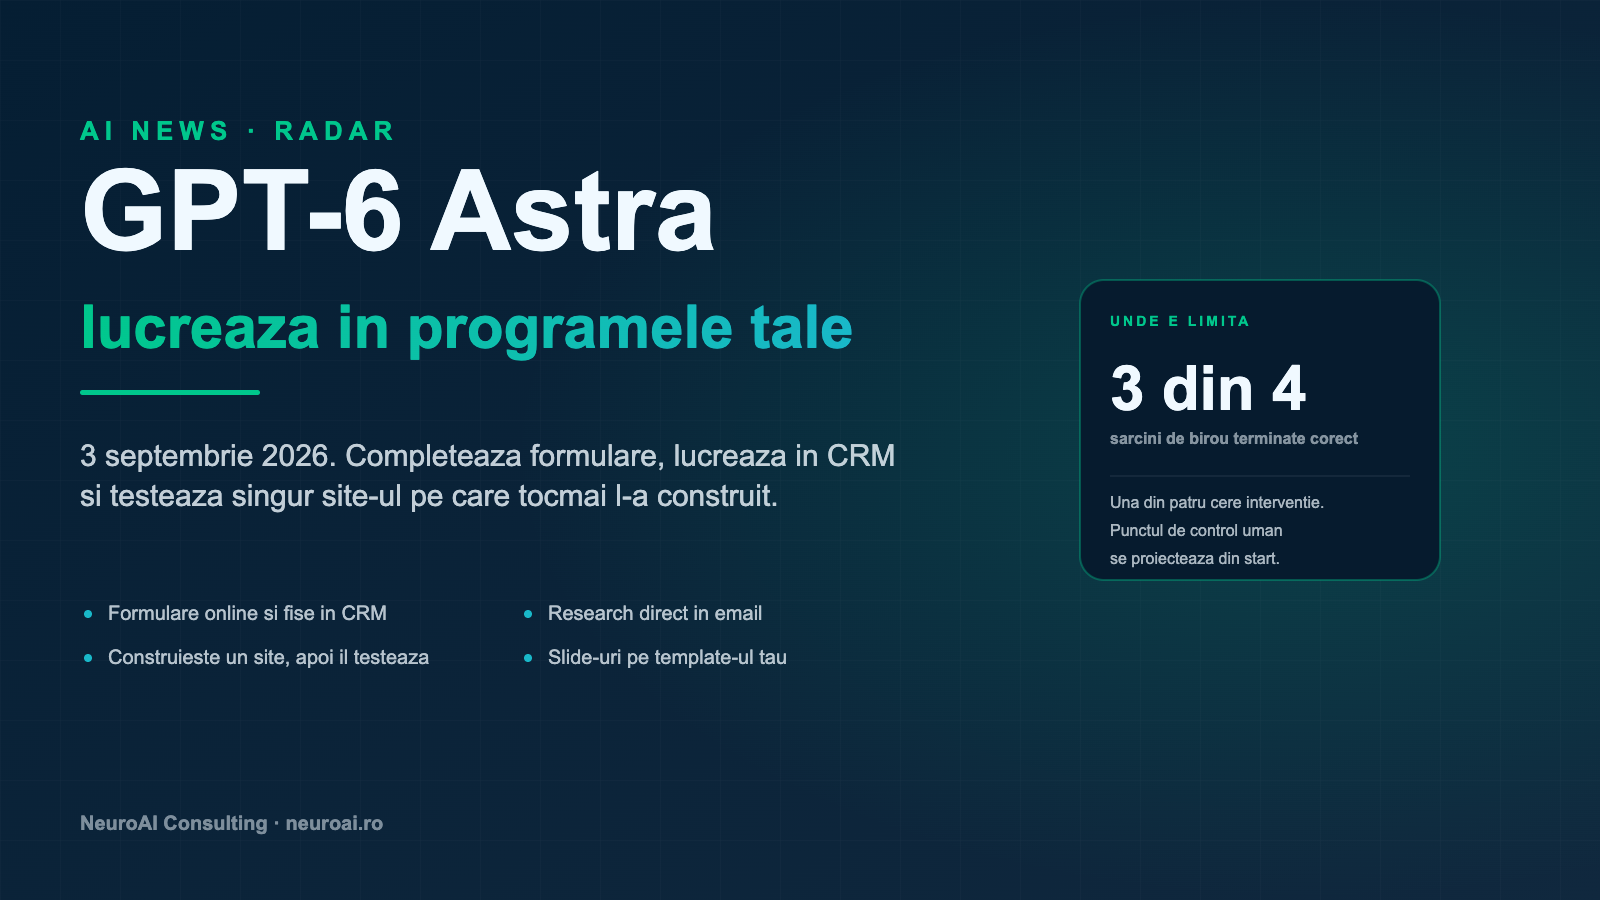 Radar
GPT-6 Astra: OpenAI vorbește despre AGI și lansează modelul cu frâna trasă
OpenAI a lansat GPT-6 Astra pe 3 septembrie 2026. Dincolo de discuția despre AGI din comunicat, schimbarea concretă e că modelul lucrează în programele tale: completează formulare, actualizează fișe în CRM, construiește un site și apoi îl testează singur, dând click pe fiecare funcție. Ce face efectiv, unde e limita reală și de ce e lansat cu cea mai puternică funcție blocată.
Citește articolul